Chi scrive articoli scientifici, specie se contengono un sacco di formule come gli articoli di matematica o di fisica, in generale usa un sistema di formattazione chiamato LaTeX. LaTeX non è un editor WYSIWYG come per esempio MS Word: di fatto è un linguaggio di programmazione (o meglio, di “marcatura”), per cui il testo viene scritto in un file sorgente secondo le regole del linguaggio, e il file formattato (di solito un PDF) viene generato in un secondo momento con un passaggio di “compilazione”, in maniera analoga a quello che si fa per un programma di computer eseguibile.
Come anche nei file sorgenti scritti in un linguaggio di programmazione come il C++ o Python, il file “sorgente” di LaTeX può contenere, oltre a testo e comandi vari, anche delle linee di commento, che il compilatore ignora e non finiranno nel PDF finale. In LaTeX le righe di commento iniziano con il simbolo di percentuale % (un po’ come in C++ si può usare // e in Python #), e sono utili per eliminare (idealmente temporaneamente) una parte di testo che non si è sicuri di voler far apparire nel documento finale. L’abuso dei commenti in LaTeX fa però sì che questi diventino a volte il ripostiglio in cui finiscono paragrafi tagliati, numeri che non convincevano del tutto, note ai coautori, o magari versioni precedenti di una tabella i cui numeri siano evoluti nel tempo.
I fisici in primis (ma ormai anche molte altre discipline scientifiche “dure”), quando sottomettono un articolo a un giornale peer-reviewed perché venga considerato per la pubblicazione, hanno preso l’abitudine di caricare la versione inviata (e dunque preliminare) su un server di pre-pubblicazione (pre-print) che si chiama arXiv, lanciato nel 1991 e diventato ormai il punto di riferimento per le pubblicazioni scientifiche. Molto prima dell’avvento delle pubblicazioni Open Access, era infatti già possibile procurarsi aggratis una versione dell’articolo senza dover pagare l’abbonamento alla rivista, o anche solo aspettare la conclusione del processo di revisione paritaria. È una pratica ormai così standard almeno nel mondo della fisica, che anche una volta pubblicato su un giornale abbiamo l’abitudine di sostituire la versione preliminare dell’articolo sull’arXiv con quella definitiva, e arXiv resta il riferimento primario per trovare rapidamente le pubblicazioni che ci servono.
Quello che molti dimenticano è che, quando un articolo viene caricato sull’arXiv, normalmente, oltre al PDF, si carica anche il file sorgente LaTeX, insieme con la versione separata di ogni file che rappresenta un grafico o una figura dell’articolo. Non è un obbligo, ma è di fatto una prassi, per lo meno per la fisica. E quando si carica il sorgente LaTeX, a meno di aver fatto pulizia prima, si caricano anche i commenti segreti e nascosti, che nessuno vede leggendo il PDF, ma che sono in teoria lì a disposizione di chi voglia andarli a cercare.
Chiariamoci, quasi nessuno lo fa, perché leggere il sorgente LaTeX non compilato di un articolo, specie se scritto da altri, non è esattamente un passatempo divertente. Ma un modello linguistico LLM, che legge tutto quello che gli si mette davanti senza stancarsi, non ha di queste remore. Questa è la seconda puntata della serie di post sulle mie avventure con i miei wiki LLM. Se nella prima raccontavo come il problema fosse un modello che aggiungeva alle fonti cose che non c’erano, qui la storia comincia, almeno in apparenza, al contrario.
Dal PDF al sorgente
Il secondo wiki LLM con cui mi sono divertito nel corso del 2026 (e anche il primo su cui ho iniziato a lavorare e sperimentare) è legato al lavoro, e raccoglie articoli e note su FCC, il futuro collider circolare del CERN. Sono partito con l’idea di costruirmi un “secondo cervello” sulla fisica del bosone di Higgs a FCC-ee, associata allo sviluppo del futuro calorimetro del rivelatore ALLEGRO, e ai metodi di machine learning per ottimizzare i rivelatori, con qualche incursione dentro i documenti prodotti per il Débat Public su FCC che ha avuto luogo quest’estate, e magari fare anche qualche esperimento di RAG. Oggi il mio wiki LLM su FCC conta circa 180 pagine, costruite a partire da un centinaio di fonti, e mi è già stato parecchio utile più di una volta per ritrovare in fretta un’informazione o fare un collegamento non necessariamente banale.
Ho iniziato a costruire questo wiki LLM dando in pasto all’agente gli articoli di fisica o sui rivelatori di FCC in formato PDF, quegli stessi che leggevo pure io. La cosa funzionava piuttosto bene, ma in un paio di occasioni ho notato che la digestione delle formule direttamente estratte dai PDF non era sempre banale, e domandava che l’agente ne generasse prima una versione grafica da poi interpretare, dove lettere greche sbagliate, apici persi e sezioni d’urto storpiate erano più frequenti di quanto non mi andasse a genio. Perché fare tutta questa (costosa, in termini di token) fatica, mi sono detto, se le formule sono anche scritte in chiaro nei sorgenti di LaTeX degli stessi articoli? Ho quindi scritto uno script che, dato un identificativo arXiv, scarica anche il sorgente LaTeX, e ho chiesto all’agente di rileggere tutti gli articoli a partire da lì, ottenendo equazioni esatte, tabelle trascritte alla lettera e un testo che costa da tre a cinque volte meno da leggere. L’agente, come tutte le macchine testarde e compiacenti, ha macinato per un po’, ed è poi tornato da me con una scoperta che non avevo considerato: insieme alle equazioni e alle tabelle, in molti dei sorgenti c’erano anche dei commenti. L’agente, a cui avevo affidato il compito di leggere tutto, ha cominciato a raccontarmi che cosa contenevano.
Cosa c’è nei commenti
Nella maggior parte dei casi si trattava di pacchetti LaTeX disattivati o di righe puramente decorative. C’erano però un certo numero di articoli in cui i commenti contenevano qualcosa di decisamente più interessante, che ho classificato in quattro categorie:
- Numeri nascosti (per ragioni più o meno buone): correlazioni calcolate e non pubblicate tra le misure di un’analisi, oppure le correzioni assolute da cui erano derivate le differenze riportate nel testo. In una rassegna, persino un’intera tabella di confronto tra metodi, nascosta perché gli autori ritenevano le condizioni sperimentali troppo diverse per poterle confrontare apertamente.
- Scelte di analisi: la lista completa delle variabili di un algoritmo di classificazione, più lunga di quella nella tabella finalmente pubblicata; o un risultato alternativo, scartato, che spiegava perché era stata scelta un’altra strada.
- Ipotesi riviste: in un articolo che faceva il confronto tra varie ipotesi di acceleratori futuri, le durate dei periodi di presa dati originali, poi invece riscalate per il risultato finale, e un commento mostra come la correzione sia arrivata in un secondo momento, durante la revisione del risultato.
- Chiacchiere tra colleghi: note a un coautore per chiedere di controllare una definizione, affiliazioni tolte, nomi spariti dalla lista degli autori.
Alcune di queste informazioni “nascoste” completano l’articolo, altre lo sfumano o addirittura lo contraddicono, con un numero diverso o con un’ipotesi che il testo non dichiara. La cosa di per sé non è così straordinaria, la genesi di un risultato scientifico è spesso più tortuosa di come la si descrive nella pubblicazione finale. La cosa più intrigante è però che queste informazioni che avrebbero vocazione a restare interne alla cerchia degli autori, siano invece pubbliche e scaricabili da chiunque, anche se con ogni probabilità quasi nessuno l’ha mai fatto.
La nota che non era nascosta
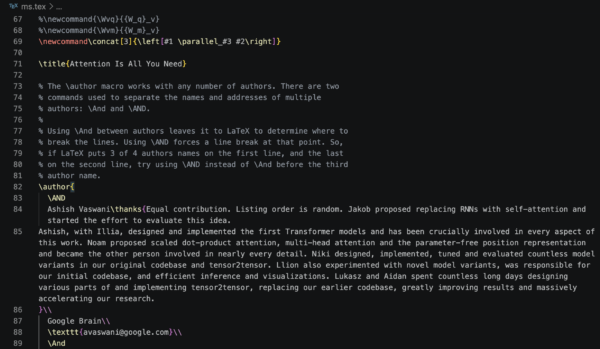
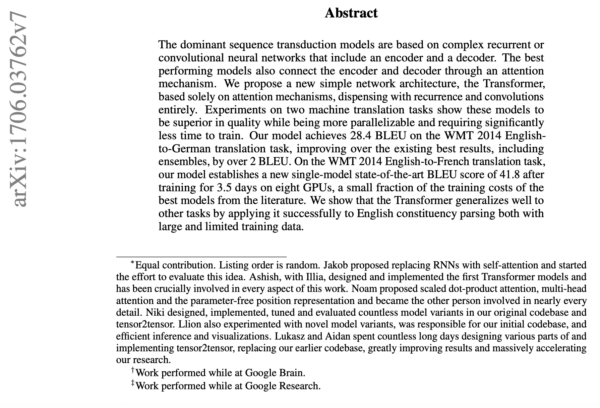
A dare fiducia al wiki LLM, la scoperta più spettacolare avrebbe riguardato l’articolo più famoso della raccolta: Attention Is All You Need, quello che nel 2017 ha introdotto il Transformer, l’architettura su cui si basano i modelli linguistici alla base degli algoritmi che stanno facendo la rivoluzione dell’AI. Secondo la pagina del wiki, il sorgente di quell’articolo conteneva una nota a piè di pagina con i contributi dei singoli autori, da chi aveva proposto di sostituire le reti ricorrenti con l’attenzione a chi aveva inventato l’attenzione multi-testa, e quella nota sarebbe stata tagliata prima della pubblicazione, tanto da non essere mai entrata nella storia ufficiale e da sopravvivere soltanto in un commento. Una bella storia, che però è falsa: quella riga del sorgente non comincia con il simbolo di percentuale e non è quindi un commento, ma una normale nota a piè di pagina, stampata nella prima pagina dell’articolo pubblicato, dove chiunque può leggerla da nove anni; per di più, la citazione riportata nella pagina del wiki saltava alcune parole senza segnalarlo. Il modello, forse preso dall’entusiasmo, aveva insomma trovato un’informazione vera, l’aveva creduta nascosta senza che lo fosse, l’aveva collocata nel posto sbagliato e ci aveva costruito sopra una narrazione di un segreto e di una storia mai raccontata, commettendo esattamente lo stesso tipo di errore della prima puntata, solo in una forma più seducente.
Cosa fare di questi segreti di Pulcinella?
Stordito dall’esperienza, sono andato di corsa a farmi rassicurare dal responsabile del Publication Committee di ATLAS sul fatto che abbiamo un sistema per “bonificare” i nostri articoli dai commenti prima di caricarli sull’arXiv (e sì, ce l’abbiamo). Mi sono poi trovato a rimuginare: che statuto ha un commento, che non è il risultato dell’articolo, perché gli autori hanno scelto di non pubblicarlo, ma non è nemmeno un errore, ed è comunque pubblico? Un wiki che lo tratti alla pari del testo finisce così per affermare cose che gli autori hanno deciso di non affermare.
C’è poi una differenza importante tra il contenuto scientifico e le persone: una correlazione non pubblicata o una variabile in più sono informazioni utili, anche per chi lavora nello stesso campo, mentre un nome tolto dalla lista degli autori o una nota a un collega sono tutt’altra cosa, perché raccontano fatti tra persone, spesso colleghi che conosco, che con la scienza hanno poco a che fare.
La regola che ho scelto per il wiki separa le due cose: il contenuto scientifico di un commento entra, con il riferimento esatto al file e alla riga e dopo aver controllato che non sia già nel PDF, mentre restano fuori le modifiche alla lista degli autori o alle affiliazioni, i nomi e le iniziali nelle note interne, le osservazioni su colleghi, revisori o lavori di altri gruppi e le dediche personali.
Due wiki, una lezione
Se nella prima puntata raccontavo di un modello che aggiungeva alle fonti cose che non c’erano, qui sono incappato in uno che ha trovato nelle fonti cose che c’erano davvero e che nessun lettore umano avrebbe visto; sono due facce della stessa capacità, quella di leggere tutto senza stancarsi e di raccontarlo bene, e il guaio è che il racconto risulta sempre convincente, tanto quando è vero quanto quando non lo è. La soluzione, nei due casi, è simile: ogni affermazione deve dire da dove viene, e quel “da dove” deve poter essere verificato da uno script. Per le citazioni dei libri basta confrontare il testo, mentre per i commenti LaTeX si può controllare che la riga citata esista, che cominci davvero con il simbolo di percentuale e che il testo non compaia nel PDF pubblicato.
Quando ho fatto controllare in questo modo tutte le affermazioni del wiki sui commenti, il risultato è stato più netto di quanto mi aspettassi: delle 260 “rivelazioni” raccolte in 17 pagine, solo una su tre è sopravvissuta intatta, mentre le altre contenevano fatti sbagliati, interpretazioni gonfiate o inventate, citazioni alterate o conteggi errati. L’errore più frequente era sempre lo stesso, simile alla storia dell’articolo fondativo dei Transformer: una copia commentata di materiale che in realtà era pubblicato altrove, nel testo, in una figura o in un’appendice, presentata come qualcosa di “tagliato” o “nascosto”, spesso con un motivo inventato dal modello per spiegarne il taglio. In un caso il modello aveva attribuito un articolo alla persona sbagliata solo perché aveva lo stesso cognome di un autore, e in un altro aveva preso la chiave bibliografica di una citazione pubblica, che portava il nome di una persona, per una comunicazione privata.
Mi pare dunque che la regola che si ricava dalle due puntate sia la stessa, forse più marcata: nel wiki dei libri le citazioni erano giuste nove volte su dieci e le sintesi due su tre, mentre qui le interpretazioni dei commenti, che sono il punto più lontano dalla fonte pubblicata e insieme il più seducente da raccontare, reggevano una volta su tre. Lo script che verifica che una riga sia davvero un commento è utile, ma non basta, perché può confermare che la riga è commentata senza poter dire se il racconto costruito sopra sia vero. E per quello, ancora una volta, serve qualcuno che rilegga.